اجرای مدلهای هوش مصنوعی بهصورت لوکال با Ollama؛ راهنمای کامل خودمیزبانی
در یک نگاه
«اجرای لوکال» یعنی مدلِ هوش مصنوعی روی کامپیوتر یا سرورِ خودتان اجرا شود، نه روی ابرِ یک شرکت. ابزارِ Ollama این کار را به یک دستورِ ساده تبدیل کرده: مدل را دانلود میکنید و بعد کاملاً آفلاین و بدون هزینهٔ توکنی با آن کار میکنید. در این راهنما یاد میگیرید Ollama چیست، چطور نصب میشود، کدام مدل برای کدام سختافزار مناسب است، چطور به برنامههایتان وصلش کنید، و کِی اجرای لوکال بهتر است و کِی سرورِ GPU ابری.
اجرای لوکال یعنی چه؟
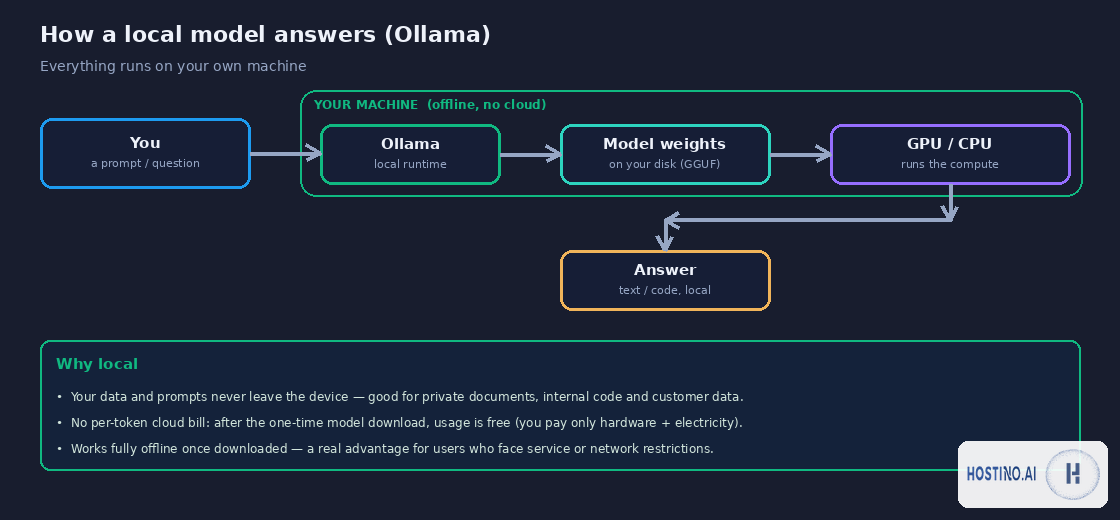
وقتی از ChatGPT یا Claude استفاده میکنید، پیامِ شما به سرورهای آن شرکت میرود، آنجا پردازش میشود و پاسخ برمیگردد. در اجرای لوکال، مدلِ زبانی روی سختافزارِ خودِ شما (کامپیوتر، لپتاپ یا سرور) اجرا میشود و پردازش همانجا انجام میگیرد. چهار مزیتِ اصلی:
- حریمِ خصوصی: داده و پرامپت از دستگاهِ شما خارج نمیشود — برای اسناد محرمانه، کدِ داخلی و دادهٔ مشتریان حیاتی است.
- بدون هزینهٔ توکنی: بعد از دانلودِ مدل، هر چقدر بخواهید استفاده میکنید؛ خبری از صورتحسابِ بهازای هر توکن نیست.
- آفلاین و بدونِ وابستگی: پس از دانلود، به اینترنت نیاز ندارید. برای کاربرانِ ایرانی این یعنی پس از دریافتِ مدل، دیگر درگیرِ تحریم و قطعی سرویس نیستید.
- کنترلِ کامل: نسخهٔ مدل ثابت میماند، سانسور یا تغییرِ ناگهانی رفتار ندارید و میتوانید مدل را برای کارِ خودتان تنظیم کنید.
Ollama چیست و چرا محبوب شد؟
Ollama یک ابزارِ متنباز و رایگان است که اجرای مدلهای زبانیِ متنباز را روی سیستمِ شخصی تا حدِ یک دستور ساده میکند. پیش از Ollama، راهاندازیِ یک مدل یعنی درگیریِ دستی با کتابخانهها، درایورِ GPU، فرمتِ وزنها و کوانتیزیشن. Ollama همهٔ اینها را پشتِ پرده مدیریت میکند: مدل را دانلود، در حافظه بارگذاری، و از GPU یا CPU برای محاسبه استفاده میکند.
Ollama روی موتورِ llama.cpp و فرمتِ GGUF ساخته شده و یک کتابخانهٔ آمادهٔ مدل دارد؛ کافی است نام مدل را بدهید. اگر هنوز با مفهومِ مدلِ زبانی آشنا نیستید، ابتدا مدل زبانی بزرگ (LLM) چیست؟ را بخوانید.
نصب Ollama (ویندوز، مک، لینوکس و Docker)
بسته به سیستمعاملتان یکی از راههای زیر را انتخاب کنید:
# Linux (نصب خودکار)
curl -fsSL https://ollama.com/install.sh | sh

# Docker (با GPU انویدیا)
docker run -d --gpus=all -v ollama:/root/.ollama \
  -p 11434:11434 --name ollama ollama/ollama
در ویندوز و مک کافی است برنامهٔ نصبی را از ollama.com دانلود و اجرا کنید؛ یک آیکون در نوارِ وظیفه ظاهر میشود و سرویس در پسزمینه بالا میآید. حداقلِ منطقی برای شروع، سیستمی با حدود ۸ گیگابایت حافظه (RAM یا VRAM) است؛ مکهای Apple Silicon بهلطفِ حافظهٔ یکپارچه عملکردِ خوبی دارند.
اولین مدل را اجرا کنید
برای شروع، یک مدلِ کوچک و باکیفیت مثل Llama 3.1 نسخهٔ ۸ میلیاردپارامتری را اجرا کنید:
ollama run llama3.1:8b # دانلود (بارِ اول) و اجرای چت ollama pull qwen3:8b # فقط دانلودِ مدل ollama list # فهرستِ مدلهای نصبشده ollama ps # مدلهایی که همین حالا در حافظهاند ollama rm gemma3:4b # حذفِ یک مدل برای آزادسازیِ فضا
بارِ اول، مدل دانلود میشود (چند گیگابایت)؛ از دفعهٔ بعد بلافاصله بالا میآید. نکته برای کاربرانِ ایران: دانلودِ مدل از رجیستریِ Ollama انجام میشود و ممکن است به تنظیماتِ شبکه نیاز داشته باشد، اما پس از دانلود، اجرا کاملاً آفلاین است.
کدام مدل برای کدام سختافزار؟
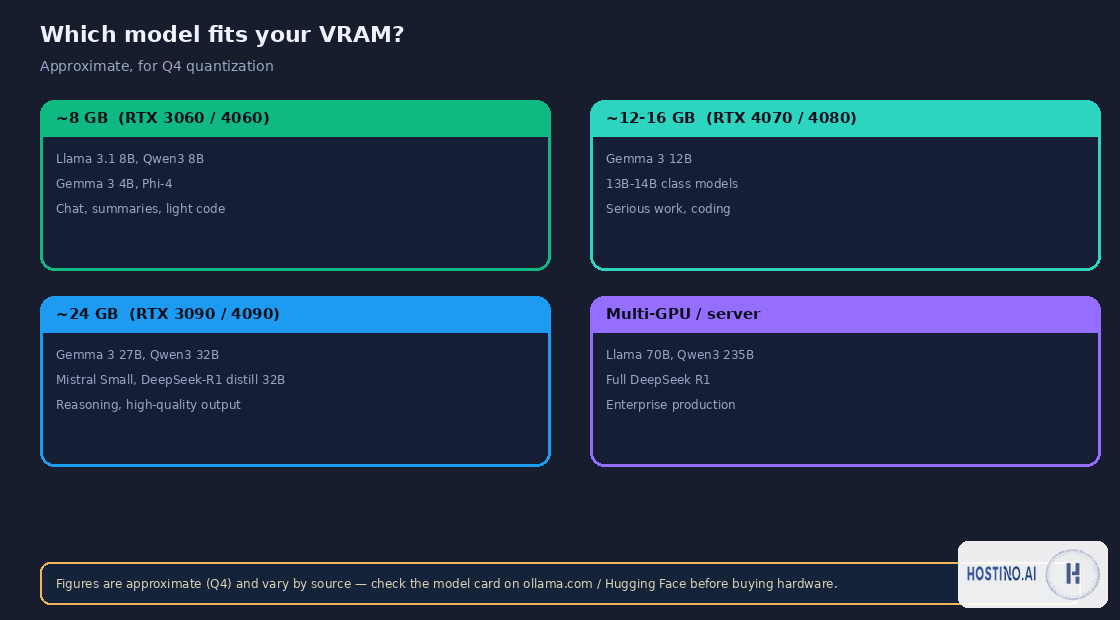
مهمترین عاملِ محدودکننده، حافظهٔ گرافیکی (VRAM) است. جدولِ زیر یک راهنمای تقریبی برای کوانتیزیشنِ Q4 است:
| حافظهٔ گرافیکی | نمونه مدلها | مناسب برای |
|---|---|---|
| ~۸ گیگ (RTX 3060/4060) | Llama 3.1 8B، Qwen3 8B، Gemma 3 4B، Phi-4 | چت، خلاصهسازی، کدِ سبک |
| ~۱۲ تا ۱۶ گیگ (RTX 4070/4080) | Gemma 3 12B، مدلهای ۱۳ تا ۱۴ میلیاردی | کارهای جدیتر، کدنویسی |
| ~۲۴ گیگ (RTX 3090/4090) | Gemma 3 27B، Qwen3 32B، Mistral Small، DeepSeek-R1 (نسخهٔ distill ۳۲B) | استدلال، خروجیِ باکیفیت |
| چندکارته / سرور | Llama 70B، Qwen3 235B، DeepSeek R1 کامل | پروداکشنِ سازمانی |
این اعداد تقریبی و برای کوانتیزیشنِ Q4 هستند و بین منابعِ مختلف فرق دارند. قبل از خریدِ سختافزار، اندازهٔ دقیقِ هر مدل را در صفحهٔ آن روی ollama.com یا Hugging Face ببینید. برای انتخابِ کارتِ گرافیک، راهنمای کدام GPU برای کدام مدل هوش مصنوعی؟ کمک میکند.
کوانتیزیشن (Quantization) به زبان ساده
وزنهای یک مدل معمولاً اعدادِ ۱۶بیتیاند. کوانتیزیشن یعنی فشردهکردنِ این اعداد به دقتِ کمتر (مثلاً ۴ بیت، یعنی Q4) تا مدل حافظهٔ کمتری بگیرد و سریعتر اجرا شود. هزینهاش افتِ جزئیِ کیفیت است که در بیشترِ کارهای روزمره محسوس نیست. قاعدهٔ سرانگشتی:
- Q4: بهترین تعادلِ کیفیت/حجم برای اجرای لوکال؛ پیشفرضِ خوبی است.
- Q8: کیفیتِ نزدیک به مدلِ کامل، اما تقریباً دو برابرِ Q4 حافظه میخواهد.
- مدلِ بزرگترِ کوانتیزهشده معمولاً از مدلِ کوچکترِ کامل بهتر جواب میدهد؛ پس اگر مجبورید انتخاب کنید، مدلِ بزرگتر با Q4 را امتحان کنید.
اتصال به برنامهها: API و رابط گرافیکی
Ollama فقط یک چتِ ترمینالی نیست؛ یک سرورِ محلی روی پورتِ 11434 بالا میآورد که میتوانید برنامههایتان را به آن وصل کنید:
# فراخوانی مستقیم API
curl http://localhost:11434/api/generate \
  -d '{"model":"llama3.1:8b","prompt":"یک جمله درباره هاستینو بنویس"}'

# نقطهٔ پایانیِ سازگار با OpenAI (برای SDKها)
# base_url: http://localhost:11434/v1
چون Ollama یک نقطهٔ پایانیِ سازگار با OpenAI دارد، بسیاری از ابزارها و SDKهایی که برای OpenAI نوشته شدهاند، فقط با تغییرِ آدرسِ پایه به Ollama وصل میشوند. برای رابطِ گرافیکیِ شبیه ChatGPT هم ابزارهایی مثل Open WebUI بهسادگی روی Ollama سوار میشوند. این یعنی میتوانید یک دستیارِ داخلیِ سازمانی بسازید بدون اینکه دادهها را به بیرون بفرستید.
لوکال یا سرورِ GPU ابری؟
اجرای لوکال عالی است، اما همیشه بهترین گزینه نیست. مقایسهٔ صادقانه:
| لوکال (سختافزارِ خودتان) | سرورِ GPU ابری | |
|---|---|---|
| هزینهٔ اولیه | خریدِ GPU (بالا) | صفر؛ پرداختِ ساعتی |
| مدلهای بزرگ | محدود به VRAM شما | تا ۷۰B و بالاتر |
| حریمِ خصوصی | کامل | خوب (سرورِ اختصاصیِ خودتان) |
| نگهداری | با خودتان | زیرساخت آماده |
قاعدهٔ ساده: برای آزمایش، یادگیری، کارهای شخصی و دادههای حساس روی یک کارتِ معمولی، لوکال بهترین است. اما وقتی به مدلِ بزرگ، چند کاربرِ همزمان یا بارِ متغیر نیاز دارید و نمیخواهید میلیونها تومان سختافزار بخرید، سرورِ GPU ابری منطقیتر است. در هاستینو میتوانید یک سرورِ GPU ساعتی بگیرید و دقیقاً همین Ollama یا ابزارهای مشابه را رویش اجرا کنید؛ جزئیات را در اجرای مدلهای هوش مصنوعی روی سرور GPU ابری آوردهایم. برای آشنایی با مدلهای متنبازِ قدرتمند هم DeepSeek V4 را ببینید.
امنیت و محدودیتها
- API را بیمحافظ باز نکنید: Ollama بهصورتِ پیشفرض فقط روی
localhostگوش میدهد. اگرOLLAMA_HOSTرا روی0.0.0.0گذاشتید تا از بیرون در دسترس باشد، حتماً فایروال و احراز هویت (مثلاً پشتِ یک پراکسی) بگذارید؛ وگرنه هر کسی میتواند از GPU شما استفاده کند. - توهم (Hallucination): مدلهای لوکال هم مثلِ بقیه ممکن است با اطمینان اشتباه بگویند. برای موضوعاتِ حقوقی، پزشکی و مالی پاسخ را راستیآزمایی کنید.
- سقفِ کیفیت: یک مدلِ ۸ تا ۳۲ میلیاردیِ لوکال معمولاً به اندازهٔ مدلهای پرچمدارِ ابری قوی نیست؛ برای کارهای بسیار پیچیده این را در نظر بگیرید.
- دانشِ محدود به تاریخ: مدل تا تاریخِ آموزشش میداند؛ برای اطلاعاتِ روز به جستوجو یا دادههای خودتان (RAG) وصلش کنید.
جمعبندی
اجرای لوکالِ مدلهای هوش مصنوعی دیگر کارِ متخصصها نیست؛ با Ollama در چند دقیقه یک دستیارِ خصوصی، رایگان و آفلاین روی سیستمِ خودتان دارید. از یک مدلِ کوچک روی کارتِ معمولی شروع کنید، با کوانتیزیشن و اندازهٔ مدل بازی کنید تا به تعادلِ درست برسید، و هر وقت به توانِ بیشتر یا مدلِ بزرگتر نیاز داشتید، سراغِ سرورِ GPU ابری بروید. مزیتِ بزرگ برای کاربرانِ ایرانی هم روشن است: پس از دانلودِ مدل، دیگر وابسته به سرویسِ هیچ شرکتی نیستید.
سوالات متداول
آیا Ollama رایگان است؟
بله، Ollama متنباز و رایگان است و مدلهای متنبازِ رایگان را اجرا میکند. تنها هزینه، سختافزارِ شما و برقِ مصرفی است.
بدونِ کارتِ گرافیک هم کار میکند؟
بله، Ollama میتواند روی CPU هم اجرا شود، اما بسیار کندتر است. برای تجربهٔ روان، یک GPU با حداقل ۸ گیگابایت VRAM یا یک مکِ Apple Silicon توصیه میشود.
از ایران میتوانم استفاده کنم؟
بله. دانلودِ اولیهٔ مدل از رجیستریِ Ollama ممکن است به تنظیماتِ شبکه نیاز داشته باشد، اما پس از دانلود، اجرا کاملاً آفلاین و بدونِ وابستگی به سرویسِ خارجی است.
کدام مدل را برای شروع نصب کنم؟
برای اغلبِ کاربران، llama3.1:8b یا qwen3:8b نقطهٔ شروعِ خوبی است: کیفیتِ قابلقبول و سازگار با کارتهای ۸ گیگابایتی.
تفاوت Ollama با LM Studio چیست؟
هر دو مدلهای لوکال را اجرا میکنند. Ollama ابزارِ خطفرمان و سرورمحور است و برای توسعهدهنده و اتصال به برنامهها عالی است؛ LM Studio رابطِ گرافیکیِ کاملتری برای کاربرانِ غیرفنی دارد.
علی کارشناس زیرساخت و شبکه است و سالها تجربهی مدیریت سرور و میزبانی وب دارد. در مقالههایش تجربههای عملیِ انتخاب و مدیریت سرور را به زبانی ساده به اشتراک میگذارد تا انتخاب درستی برای هر پروژه ممکن شود.
مقالههای بیشتر از علی محمدی ←