DeepSeek V4 چیست؟ بررسی کامل قدرتمندترین مدل هوش مصنوعی متنباز (Pro و Flash)
در یک نگاه
DeepSeek V4 جدیدترین نسلِ مدلهای شرکتِ چینیِ DeepSeek و یکی از قدرتمندترین مدلهای متنباز (Open-Weights) جهان است. این مدل در دو نسخه عرضه شده — V4-Pro با ۱.۶ تریلیون پارامتر و V4-Flash با ۲۸۴ میلیارد پارامتر — هر دو با لایسنسِ آزادِ MIT روی Hugging Face و با پنجرهٔ متنِ ۱ میلیون توکنی. نکتهٔ مهم برای ما: چون وزنهای مدل باز است، میتوانید آن را روی سرورِ GPU خودتان اجرا کنید.
سالِ ۲۰۲۶ سالِ انفجارِ مدلهای متنباز بود و DeepSeek یکی از بازیگرانِ اصلیِ این میدان است. اگر تا حالا دربارهٔ Kimi K3 یا شیائومی MiMo خواندهاید، حالا وقتِ آشنایی با رقیبی است که خیلیها آن را «نزدیکترین مدلِ متنباز به مدلهای بستهٔ پرچمدار» میدانند. در این مقاله DeepSeek V4 را کامل بررسی میکنیم و میبینیم چطور میتوانید از آن — حتی روی زیرساختِ خودتان — استفاده کنید.
DeepSeek V4 چیست؟
DeepSeek V4 یک مدلِ زبانیِ بزرگ (LLM) با معماریِ Mixture-of-Experts (MoE) است. در این معماری، مدل مجموعهای از «متخصصها» دارد و برای هر درخواست فقط بخشی از آنها فعال میشوند؛ به همین دلیل با اینکه تعدادِ کلِ پارامترها بسیار زیاد است، هزینهٔ محاسباتیِ هر پاسخ بهشکلِ چشمگیری کمتر میماند. مدل در آوریلِ ۲۰۲۶ بهصورتِ Preview منتشر شد و از آن زمان چکپوینتهای بهروزتری (مثل نسخهٔ Flash-0731) هم عرضه شده است.
دو نسخه: Pro و Flash
DeepSeek V4 در دو رده عرضه شده تا هم برای بیشترین کیفیت و هم برای سرعت و صرفهجویی گزینه داشته باشید:
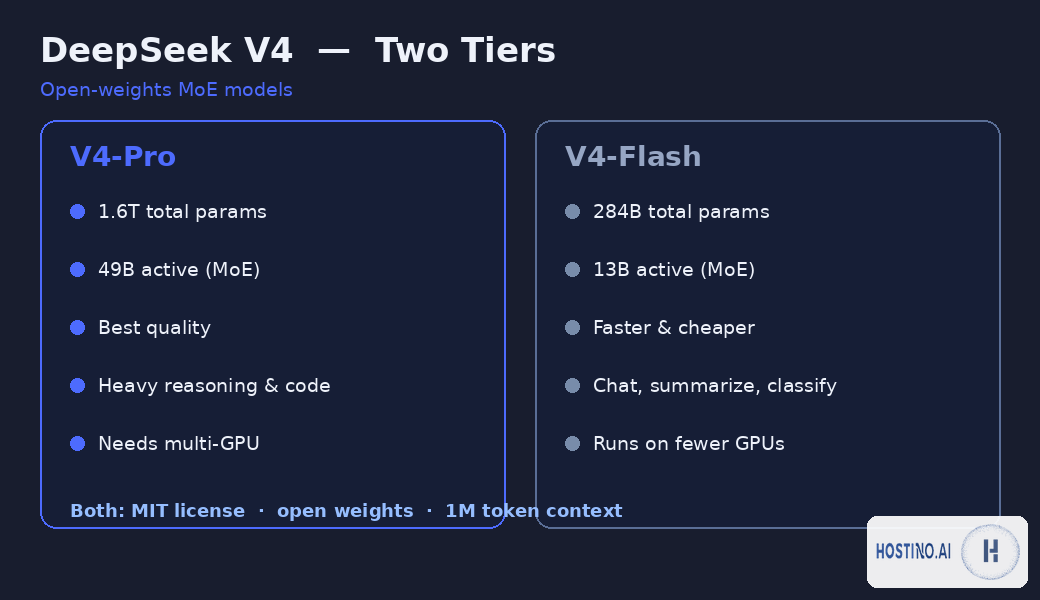
- V4-Pro: حدودِ ۱.۶ تریلیون پارامترِ کل (~۴۹ میلیارد فعال در هر پاسخ). بزرگترین مدلِ متنبازِ در دسترس در زمانِ عرضه؛ برای کارهای پیچیده، استدلال و کدنویسیِ سنگین.
- V4-Flash: حدودِ ۲۸۴ میلیارد پارامترِ کل (~۱۳ میلیارد فعال). سریعتر و بسیار ارزانتر؛ برای چت، خلاصهسازی، دستهبندی و کاربردهای حجمِ بالا.
- هر دو نسخه از طریقِ API با پنجرهٔ متنِ ۱ میلیون توکنی در دسترساند — یعنی میتوانید کتاب، کدِبیسِ کامل یا اسنادِ طولانی را یکجا به مدل بدهید.
متنباز با لایسنسِ MIT؛ چرا مهم است؟
مهمترین ویژگیِ DeepSeek V4 برای کسبوکارها این است که وزنهای مدل بهصورتِ باز و تحتِ لایسنسِ سخاوتمندانهٔ MIT روی Hugging Face و ModelScope منتشر شدهاند. این یعنی:
- اجرای خصوصی: میتوانید مدل را روی سرورِ خودتان اجرا کنید و دادههایتان از سازمان خارج نشود — مزیتی بزرگ برای حریمِ خصوصی و انطباق.
- بدونِ قفلِ فروشنده (Vendor Lock-in): وابسته به API یک شرکتِ خاص نیستید.
- استفادهٔ تجاری: لایسنسِ MIT اجازهٔ استفادهٔ تجاری و شخصیسازی میدهد.
- کنترلِ هزینه: بهجای پرداختِ بهازای هر توکن، فقط هزینهٔ سرورِ GPU را میدهید که برای حجمِ بالا مقرونبهصرفهتر است.
عملکرد و بنچمارک
طبق اعلامِ DeepSeek، نسخهٔ Pro در بنچمارکهای کدنویسی و عاملی (Agentic) عملکردی همردهٔ مدلهای بستهٔ نسلِ قبل مثلِ GPT-5.5 و Claude Opus 4.7 ارائه میدهد — و این را با کسری از هزینه. برآوردِ خودِ شرکت این است که فاصلهٔ V4 با بهترین مدلهای بسته تنها حدودِ ۳ تا ۶ ماه است.
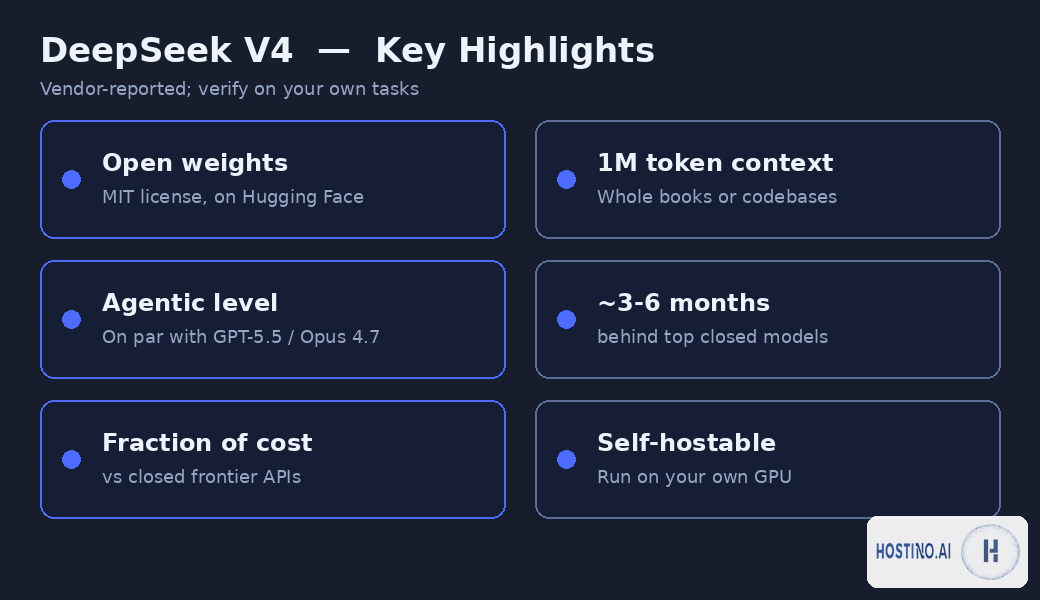
یک نکتهٔ مهم: بنچمارکهای اعلامشده توسطِ سازنده را همیشه با احتیاط ببینید؛ بهترین سنجش، تستِ مدل روی کارِ واقعیِ خودتان است. خبر خوب اینکه چون مدل متنباز است، این تست برایتان رایگان و کاملاً در دسترس است.
چطور از DeepSeek V4 استفاده کنیم؟
دو راه دارید:
- ۱) از طریقِ API رسمیِ DeepSeek: سریعترین راه برای شروع؛ کافی است یک کلید API بگیرید. برای پروژههای کوچک و آزمایش عالی است.
- ۲) اجرای خصوصی روی سرورِ GPU: اگر حجمِ کارتان بالاست، به حریمِ خصوصی نیاز دارید، یا میخواهید هزینه را کنترل کنید، مدل را روی سرورِ GPU خودتان بالا میآورید (مثلاً با ابزارهایی مثلِ vLLM یا SGLang).
اجرای DeepSeek V4 روی سرورِ GPU هاستینو
برای اجرای این مدلها به حافظهٔ گرافیکی (VRAM) کافی نیاز دارید. یک قانونِ سرانگشتی:
- V4-Flash (۲۸۴B) را میتوان با کوانتیزیشن روی یک یا چند GPU پرVRAM اجرا کرد — نقطهٔ شروعِ منطقی برای بیشترِ کسبوکارها.
- V4-Pro (۱.۶T) به چند GPU و پیکربندیِ حرفهای نیاز دارد؛ مناسبِ تیمهای بزرگ و بارِ کاریِ سنگین.
اگر نمیخواهید درگیرِ خریدِ سختافزارِ گران شوید، میتوانید سرورِ GPU ابریِ هاستینو را ساعتی یا ماهانه اجاره کنید و مدل را رویش بالا بیاورید — بدونِ هزینهٔ اولیهٔ سنگین و با امکانِ مقیاسپذیری. برای آشنایی با انتخابِ کارتِ مناسب، راهنمای کدام GPU برای کدام مدل و اجرای مدلها روی سرورِ GPU ابری را بخوانید.
DeepSeek V4 در برابر رقبا
در فضای متنباز، DeepSeek V4 در کنارِ Kimi K3 و مدلهای دیگر یکی از قویترین گزینههاست؛ و در برابرِ مدلهای بسته مثلِ ChatGPT و Claude و Gemini، مزیتِ اصلیاش آزادی و کنترل است، نه لزوماً بالاترین امتیازِ بنچمارک. اگر حریمِ خصوصی، هزینهٔ قابلپیشبینی و استقلال از یک فروشنده برایتان مهم است، V4 انتخابی جدی است.
سوالات متداول
DeepSeek V4 رایگان است؟
وزنهای مدل تحتِ لایسنسِ MIT رایگان و باز هستند؛ اما اجرای آن نیازمندِ سختافزارِ GPU است (یا استفاده از API که هزینهٔ بهازای توکن دارد).
تفاوتِ Pro و Flash چیست؟
Pro بزرگتر و باکیفیتتر ولی سنگینتر است؛ Flash سبکتر، سریعتر و ارزانتر برای کاربردهای حجمِ بالا.
میتوانم آن را روی سرورِ خودم اجرا کنم؟
بله؛ دقیقاً مزیتِ متنباز بودن همین است. با یک سرورِ GPU و ابزارهایی مثلِ vLLM میتوانید مدل را خصوصی اجرا کنید.
پنجرهٔ متنِ ۱ میلیون توکنی یعنی چه؟
یعنی مدل میتواند حجمِ بسیار زیادی از متن (کتابها یا کدِبیسِ کامل) را یکجا در نظر بگیرد. برای درکِ بهتر، مقالهٔ توکن و پنجرهٔ متن را ببینید.
جمعبندی
DeepSeek V4 نشان میدهد که فاصلهٔ مدلهای متنباز با مدلهای بستهٔ پرچمدار هر روز کمتر میشود. برای کسبوکارهایی که به حریمِ خصوصی، کنترلِ هزینه و استقلال اهمیت میدهند، این مدل یک فرصتِ واقعی است — بهشرطِ داشتنِ زیرساختِ GPU مناسب. اگر میخواهید DeepSeek V4 یا هر مدلِ متنبازِ دیگری را بدونِ دردسرِ خریدِ سختافزار اجرا کنید، سرورِ GPU ابریِ هاستینو نقطهٔ شروعِ ساده و مقیاسپذیری برای شماست.

اهورا دربارهی فناوریهای نوین، هوش مصنوعی و تأثیر آنها بر کسبوکارهای آنلاین مینویسد. هدف او سادهکردن مفاهیم پیچیده است تا خوانندگان بدون پیشزمینهی فنی هم بتوانند از این فناوریها بهره ببرند.
مقالههای بیشتر از اهورا سپندار ←