NVIDIA Vera Rubin؛ نسل بعدی سختافزار هوش مصنوعی (بعد از Blackwell)
در یک نگاه
NVIDIA Vera Rubin نسلِ تازهٔ معماریِ هوش مصنوعیِ انویدیا است که در CES ۲۰۲۶ (ژانویه) رونمایی شد و جانشینِ نسلِ Blackwell است. برخلافِ تصور، Rubin یک «کارتِ گرافیک» تنها نیست، بلکه یک پلتفرمِ کاملِ رَکمقیاس (rack-scale) از شش تراشهٔ همطراحیشده است. مهمترین ادعای انویدیا: تا ۱۰ برابر هزینهٔ کمترِ هر توکن و تا ۵ برابر کاراییِ استنتاجِ بیشتر نسبت به Blackwell. عرضهٔ محصولاتِ شریکان و ابرها در نیمهٔ دوم ۲۰۲۶ است.
هر چند سال یکبار، انویدیا معماریِ تازهای معرفی میکند که کلِ اقتصادِ هوش مصنوعی را جابهجا میکند. امسال نوبتِ Vera Rubin است — بهنامِ ستارهشناسِ نامدار وِرا رابین. اگر با انتخابِ GPU برای مدلهای هوش مصنوعی یا تفاوت CPU و GPU آشنا هستید، این مقاله نشان میدهد نسلِ بعدیِ سختافزارِ AI چه تغییری ایجاد میکند و چرا برای کسبوکارها مهم است.
Vera Rubin دقیقاً چیست؟
Vera Rubin یک پلتفرمِ رَکمقیاس است، نه یک تراشهٔ منفرد. انویدیا آن را با «همطراحیِ افراطی (extreme co-design)» میانِ شش تراشهٔ جدید ساخته است. نامها هم معنادارند: «Vera» همان پردازندهٔ مرکزی (CPU) و «Rubin» همان پردازندهٔ گرافیکی (GPU) است.
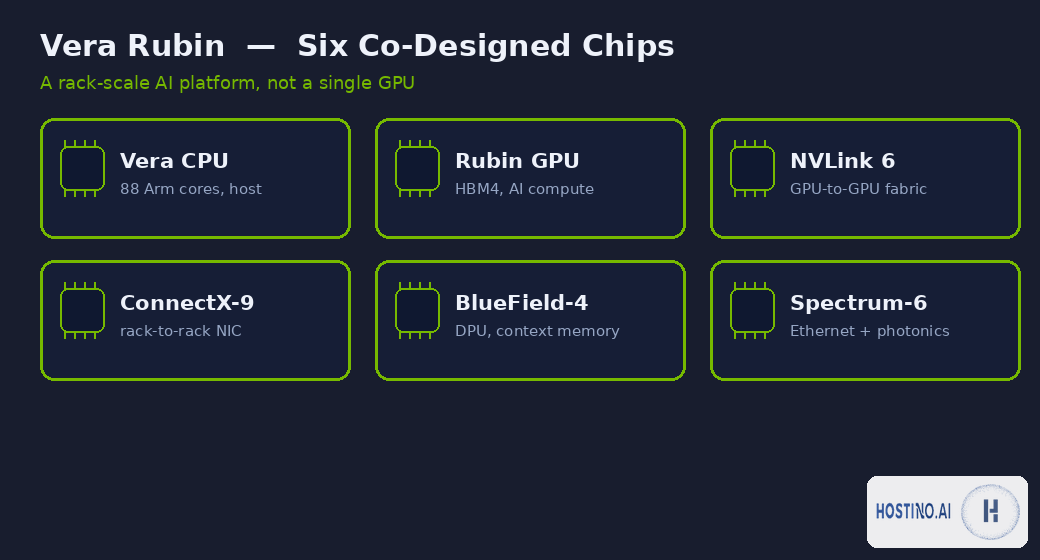
| تراشه | نقش |
|---|---|
| Vera CPU | پردازندهٔ میزبان با ۸۸ هستهٔ سفارشیِ Arm؛ تغذیهٔ GPUها |
| Rubin GPU | شتابدهندهٔ اصلیِ AI؛ نخستین GPU انویدیا با حافظهٔ HBM4 |
| NVLink 6 Switch | بافتِ اتصالِ GPU-به-GPU درونِ رَک (پهنای باندِ بسیار بالا) |
| ConnectX-9 SuperNIC | کارتِ شبکهٔ اتصالِ رَکبهرَک (۸۰۰ گیگابیت بر ثانیه هر پورت) |
| BlueField-4 DPU | واحدِ پردازشِ داده؛ مدیریتِ حافظهٔ متن (KV-cache) برای استنتاجِ طولانی |
| Spectrum-6 Switch | سوییچِ اترنتِ نسلِ بعد با فوتونیکِ همبستهبندی |
NVL72 در برابر NVL8
- Vera Rubin NVL72: سیستمِ پرچمدارِ رَکمقیاس با ۷۲ عدد GPU رابین + ۳۶ عدد CPU وِرا، اتصالِ همهبههمه با NVLink 6، خنککاریِ مایع و طراحیِ بدونِ کابل. انویدیا میگوید «مونتاژ و سرویسِ آن ۱۸ برابر سریعتر از Blackwell است».
- HGX Rubin NVL8: یک بردِ سرورِ ۸-GPUیِ سنتی برای سرورهای x86 — گزینهٔ سادهترِ جایگذاری در سرورهای استاندارد بهجای یک رَکِ کامل.
ادعاهای عملکردی نسبت به Blackwell
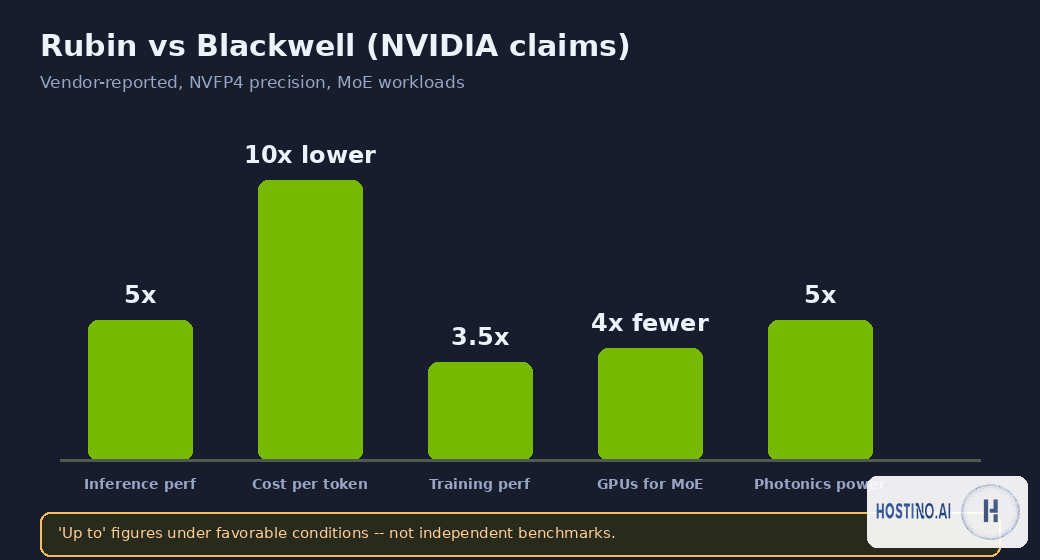
| شاخص | ادعای انویدیا نسبت به Blackwell |
|---|---|
| کارایی استنتاج (Inference) | تا ۵ برابر بیشتر |
| هزینهٔ هر توکن | تا ۱۰ برابر کمتر (برای مدلهای MoE) |
| کارایی آموزش (Training) | حدود ۳.۵ برابر بیشتر |
| تعداد GPU برای آموزش MoE | ۴ برابر کمتر (یکچهارم) |
| بهرهوریِ توانِ فوتونیک (Spectrum-X) | تا ۵ برابر بهتر |
مهم و صادقانه: همهٔ این اعداد ادعای انویدیا هستند (نه بنچمارکِ مستقل) و در بهترین شرایط و با دقتِ عددیِ NVFP4 (۴-بیتی) اندازهگیری شدهاند؛ پس با نتایجِ FP8/FP16 مستقیم قابلمقایسه نیستند و «تا X برابر» یعنی سقفِ ادعا، نه تضمینِ دنیای واقعی.
مشخصاتِ کلیدیِ Rubin GPU
- حافظه: تا ۲۸۸ گیگابایت HBM4 در هر GPU با پهنای باندِ تا ۲۲ ترابایت بر ثانیه — حدودِ ۲.۸ برابرِ Blackwell. نخستین GPUای که HBM4 را یکپارچه کرده است.
- NVLink 6: ۳.۶ ترابایت بر ثانیه در هر GPU (دو برابرِ Blackwell)؛ مجموعِ ۲۶۰ ترابایت بر ثانیه در هر رَکِ NVL72.
- محاسبات: ۵۰ پتافلاپس استنتاج و ۳۵ پتافلاپس آموزش (NVFP4) در هر GPU؛ حدودِ ۳۳۶ میلیارد ترانزیستور.
نقشهٔ راه: از Blackwell تا Feynman
انویدیا آهنگِ عرضهٔ سالانه دارد:
| نسل | زمان | نکتهٔ کلیدی |
|---|---|---|
| Blackwell / Blackwell Ultra | ۲۰۲۴–۲۰۲۵ | نسلِ فعلی (B200/B300) |
| Rubin | نیمهٔ دوم ۲۰۲۶ | رَک NVL72، حافظهٔ HBM4، ۲۸۸GB |
| Rubin Ultra | نیمهٔ دوم ۲۰۲۷ | رَکهای NVL576 «Kyber»؛ نخستین GPU با ۱ ترابایت HBM4E |
| Feynman | ۲۰۲۸ | مقیاسِ گیگاواتی با CPU جدید «Rosa» |
چه زمانی و کجا در دسترس است؟
Rubin در زمانِ رونمایی در تولیدِ انبوه اعلام شد و محصولاتِ شریکان و ابرها در نیمهٔ دوم ۲۰۲۶ عرضه میشوند. نخستین ارائهدهندگانِ ابری: AWS، Google Cloud، Microsoft Azure و Oracle (OCI) بههمراه CoreWeave و Lambda و Nebius؛ سازندگان: Dell، HPE، Lenovo و Supermicro.
چرا برای کسبوکارها و اجارهکنندگانِ GPU مهم است؟
قلبِ داستانِ Rubin، اقتصادِ هزینهٔ هر توکن است. با ادعای ۱۰ برابر هزینهٔ کمترِ هر توکن و «توکنِ بیشتر بهازای هر وات»، یعنی سرویسدهیِ یک مدلِ استنتاج بسیار ارزانتر میشود؛ و آموزشِ مدلهای MoE با ۴ برابر GPU کمتر ممکن است. این یعنی اقتصادِ واحدِ بهترِ کسبوکارهای مبتنی بر هوش مصنوعی. اما توجه کنید که این سیستمهای رَکمقیاس بسیار گران و پرمصرفاند و برای بیشترِ کسبوکارها فقط از راهِ اجارهٔ ابری در دسترساند — نه خریدِ مستقیم.
اگر میخواهید مدلهای هوش مصنوعی را بدونِ خریدِ سختافزارِ گران اجرا کنید، همین امروز میتوانید با سرور GPU ابری هاستینو شروع کنید و با بهبازارآمدنِ نسلهای تازه، زیرساختتان را مقیاس دهید. برای انتخابِ درست، راهنمای کدام GPU برای کدام مدل و اجرای مدلها روی سرور GPU ابری را ببینید.
سوالات متداول
Rubin یک کارت گرافیک است؟
خیر؛ یک پلتفرمِ کاملِ رَکمقیاس از شش تراشه است. «Rubin» نامِ GPU آن و «Vera» نامِ CPU آن است.
چقدر از Blackwell بهتر است؟
طبقِ ادعای انویدیا تا ۵ برابر استنتاجِ سریعتر و ۱۰ برابر هزینهٔ کمترِ هر توکن؛ اما اینها اعدادِ سازندهاند و باید با بنچمارکِ مستقل سنجیده شوند.
کِی میتوانم استفاده کنم؟
نیمهٔ دوم ۲۰۲۶ از طریقِ ابرها؛ در آغاز معمولاً محدود و اولویت با ابرهای بزرگ است.
HBM4 چیست و چرا مهم است؟
نسلِ تازهٔ حافظهٔ پرسرعتِ GPU؛ پهنای باندِ بالاترش گلوگاهِ حافظه را در مدلهای بزرگ کم میکند. برای درکِ بهتر، مقالهٔ انتخاب GPU را ببینید.
جمعبندی
Vera Rubin نشان میدهد که رقابتِ هوش مصنوعی حالا بهاندازهٔ مدلها، به سختافزار و اقتصادِ هر توکن هم وابسته است. برای کسبوکارها، پیام روشن است: هزینهٔ اجرای هوش مصنوعی رو به کاهش است. اگر میخواهید از همین امروز و بدونِ هزینهٔ سنگینِ سختافزار، مدلهای هوش مصنوعی را اجرا کنید، سرور GPU ابری هاستینو نقطهٔ شروعِ ساده و مقیاسپذیری برای شماست.

اهورا دربارهی فناوریهای نوین، هوش مصنوعی و تأثیر آنها بر کسبوکارهای آنلاین مینویسد. هدف او سادهکردن مفاهیم پیچیده است تا خوانندگان بدون پیشزمینهی فنی هم بتوانند از این فناوریها بهره ببرند.
مقالههای بیشتر از اهورا سپندار ←